
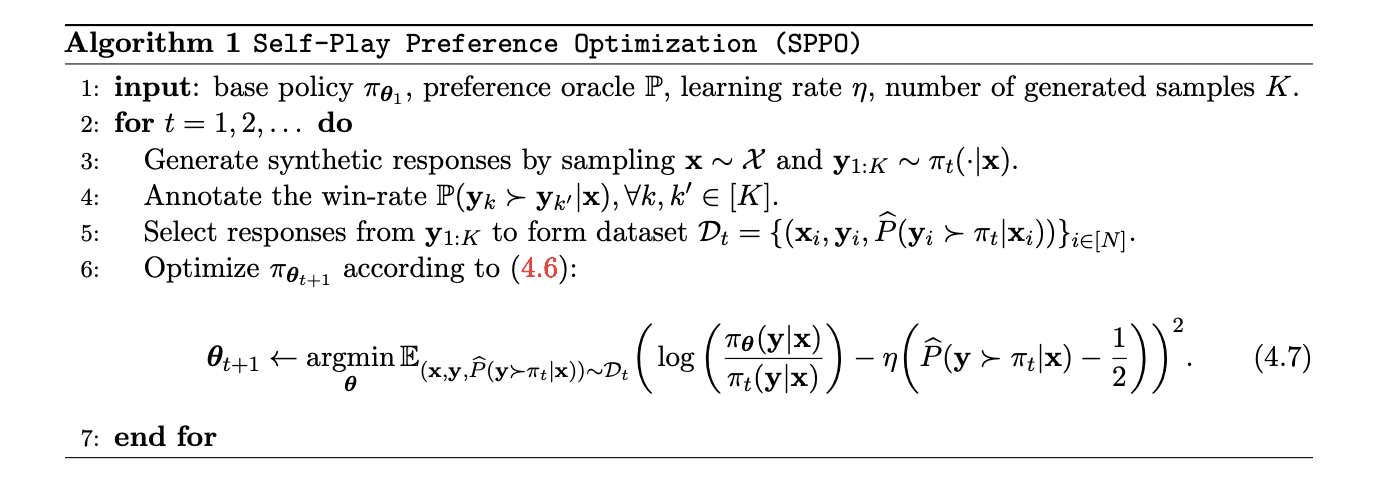
– Large Language Models (LLMs) are evolving rapidly, showcasing human-like capabilities in text generation, question answering, and coding…
– Large Language Models (LLMs) are evolving rapidly, showcasing human-like capabilities in text generation, question answering, and coding…Continue reading on Medium » Read More AI on Medium
#AI